


2. 中国矿业大学(北京) 煤炭精细勘探与智能开发全国重点实验室, 北京 100083;
3. 清华大学 安全科学学院, 北京 100084
2. State Key Laboratory for Fine Exploration and Intelligent Development of Coal Resources, China University of Mining and Technology-Beijing, Beijing 100083, China;
3. School of Safety Science, Tsinghua University, Beijing 100084, China
煤矿安全生产领域积累了大量的隐患记录和事故案例分析报告等风险数据,可为相关人员分析事故原因、总结教训和增加经验提供参考[1-2]。学习事故案例是预防同类事故再次发生的有效途径,然而,从事故分析内容来看,中国的事故调查报告中事故原因仅笼统地分为直接原因和间接原因,不利于人们从事故中获取经验和教训[3]。
事故致因理论是保证有效和科学分析事故的关键[4-5]。事故因果关系模型已发展了100多年[6],近年来,事故致因“2-4”模型(24Model)、事故分析映射(accident analyse mapping,AcciMap)、人因分析与分类系统(human factors analysis and classification system,HFACS)、功能共振分析方法(functional resonance analysis method,FRAM)、系统理论事故模型和过程(systems-theoretic accident model and processes,STAMP)等理论陆续应用于煤矿事故分析中[7-9],且不同事故致因理论有不同的分析框架。然而,几乎所有方法都严重依赖人工分析,存在分析效率低[10]和准确度受分析者的主观影响较强(取决于事故分析者的工作经验和应用事故致因分析方法的熟练程度)[11]等问题。分析效率低的原因是人工可接受和处理的事故信息量有限,导致企业无法充分利用大数据技术优势为企业安全管理提供更多的决策意见;准确度受分析者的主观影响较强则容易导致事故分析结果不一致,即使采用同种事故致因理论,不同的人分析同一事故依然会产生不一样的结果[12]。
随着安全生产数字化技术的发展,智能安全管理成为必然趋势[13],基于大数据分析的案例研究可为安全问题研究提供良好的技术支撑[14-16]。利用自然语言处理(natural language processing, NLP)技术可从事故文本中提取关键信息,快速挖掘风险因素和事故原因[17-18],缩短相关人员处理事故案例文本的时间[19]。
大多数现有研究直接将数据挖掘技术应用于事故文本分析,并提取相应的事故信息和风险因素,忽略了事故致因理论,导致数据挖掘结果缺乏系统性和逻辑性。同时,随着深度学习、知识图谱和增强学习等新一代人工智能技术的发展,人工智能技术逐步从数据感知过渡到数据认知,传统文本挖掘方法已无法胜任更深层次的文本识别任务。
针对现有研究的不足,本文结合人工智能技术和事故致因理论,提出了一种高效智能的事故分析方法。本文首先利用命名实体识别(named entity recognition,NER)技术提取事故案例的全要素信息,全面提升了模型对事故信息的感知能力;其次,根据24Model提取事故原因的文本表示模式,结合语义依存分析(semantic dependency parsing,SDP)技术和文本分类(text classification, TC)方法,精准识别出事故报告中的个体不安全动作和组织原因;最后,评估了所提方法的可行性。本文研究结果可促进人工智能技术在煤矿事故致因分析中的应用,为相关人员学习和分析事故案例提供参考。
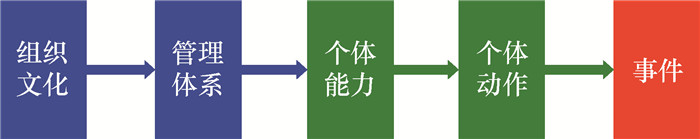
1 理论框架24Model由傅贵等[20]于2005年提出,如今已形成一套较完备的事故分析理论体系,主要用于探索安全管理体系运行的动态逻辑和员工行为,在国内外事故分析领域具有较大影响力。24Model借鉴了Heinrich[21]提出并改进的Domino骨牌系列模型、Reason[22]提出并具体化的瑞士奶酪系列模型和人因分类系统、Stewart[23]提出的卓越安全管理模型,对事故致因分析具有系统、动态和非线性等特点[20]。24Model明确了各原因模块的内涵和定义,提供了系统的事故致因分析框架,静态结构如图 1所示。
|
| 图 1 24Model静态结构 |
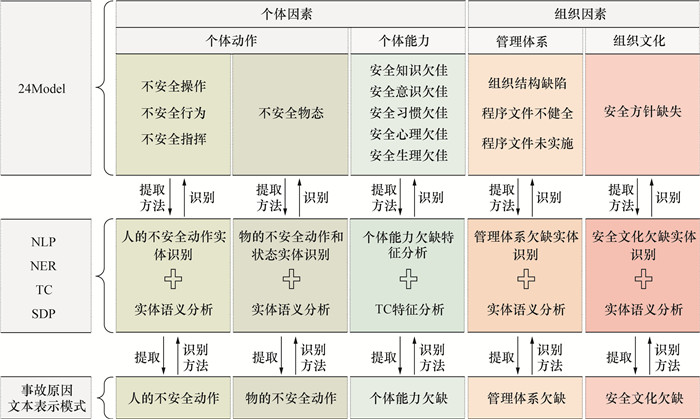
24Model对事故原因进行了系统的阐述和编码,具有较强的实践性和可操作性[24],可促进智能化技术应用于事故原因分析。本文在大量人工标注工作的基础上,训练了可靠的NER模型,可直接从事故文本中识别人员、组织机构、设备、环境和程序文件等实体信息。由于NER的结果是一些离散的词信息,仅提取事故实体信息无法表达事故文本的确切含义,因此本文引入SDP和TC技术,提出了适用于24Model的原因识别方法,分析不同原因类别中实体之间的语义结构关系和特征。事故智能分析技术框架如图 2所示。
|
| 图 2 事故智能分析技术框架图 |
事故原因识别主要包括以下环节:
1) 收集数据:从煤矿事故案例报告中获取原始文本数据,用于训练NER和TC模型。
2) 构建语料库:在NER方面,根据本文构建的概念体系人工标注文本中的实体;在TC方面,根据24Model定义的原因类别,从事故和风险文本中标注对应内容。将上述标注的内容和类别标签形成文本集合,构建NER和TC语料库。
3) 选择算法和训练模型:根据任务和场景、具体任务要求及数据特征,基于双向编码器表征(bidirectional encoder representations from transformers,BERT)法、双向长短期记忆(bidirectional long short-term memory, BiLSTM)网络和条件随机场(conditional random field,CRF),集成BERT-BiLSTM-CRF框架进行实体抽取任务。此外,BERT还用于个体能力原因分类任务。使用语料库和算法训练模型,逐步调整模型参数和权重,提高相应任务的准确率和泛化能力。
4) 评价模型:选择评价指标,利用测试数据评价训练好的模型,可确定模型的分类性能。
5) 文本SDP:利用SDP技术分析事故文本,获取实体类别的语义结构关系。
6) 提取事故原因表示模式:根据24Model中各原因类别的定义,分析各原因实体类别的语义关系,提取表示模式。
7) 模型应用:根据本文所提方法开发应用程序,实现对煤矿事故的智能分析和信息提取。
2 煤矿事故NER 2.1 概念体系本文定义的煤矿安全领域实体类别主要由影响煤矿安全生产的各类实体对象组成。目前,煤矿事故领域尚无完善的概念体系,本文利用自下而上的概念体系构建方法逐层分解知识单元,从大量煤矿事故分析文献、事故调查报告和相关法律标准中得到与煤矿事故相关性较强的概念。
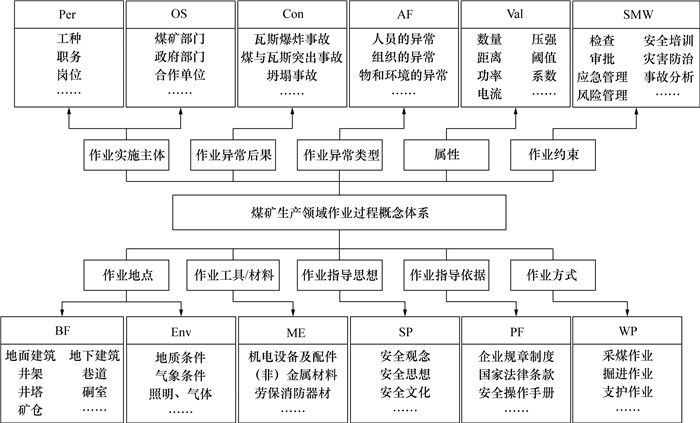
为保证概念的专业性,本文从102部煤矿安全法规和标准中提取相关专业术语,形成煤矿安全管理词库,并对词库进行了整理分类;根据煤矿生产作业活动,确定了人员(Per)、组织机构(OS)、事故(Con)、异常特征(AF)、值(Val)、安全管理(SMW)、建筑设施(BF)、环境(Env)、设备物资(ME)、安全方针(SP)、程序文件(PF)、作业工序(WP)共12个实体类别,如图 3所示。
|
| 图 3 煤矿安全管理概念体系 |
2.2 NER训练
大量的煤矿事故数据对事故致因模型提出了更高要求,本文注重模型的稳定和实践应用效果,利用BERT-BiLSTM-CRF模型执行NER任务,该模型可充分利用上下文信息和标签依赖关系提高NER的准确度和性能[25]。本文收集了660起煤矿事故案例文本,按照8∶1∶1的比例划分训练集、测试集和验证集,并采用BIO(B用于标注实体的起始字符;I用于标注实体的中间和结尾字符;O用于标注非实体字符)方法标注文本中的实体。例如,安全员属于Per实体类型,标签可表示为“安:B-Per”“全:I-Per”“员:I-Per”。
2.2.1 BERT-BiLSTM-CRF模型1) BERT模型。
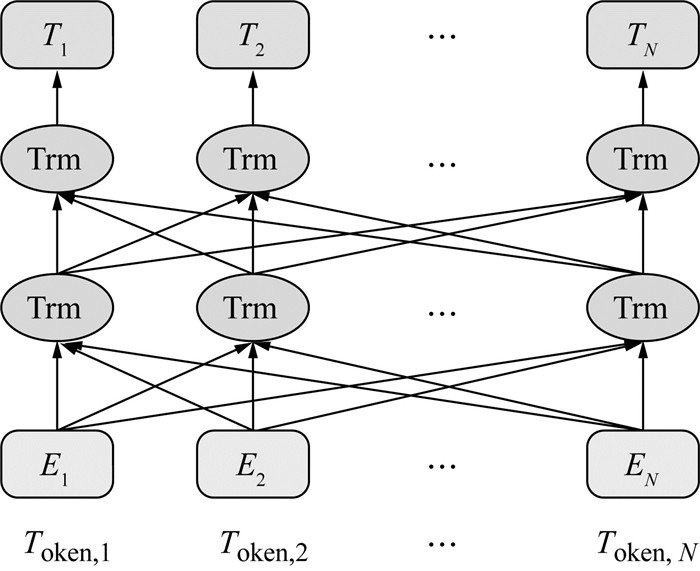
目前,BERT模型在NLP领域广泛应用于NER、关系抽取、TC和文本生成等任务[26]。BERT模型结构如图 4所示,其中:Token, 1,Token, 2,…,Token, N为输入文本;E1,E2,…,EN为嵌入序列;Trm为转换器;T1,T2,…,TN为文本序列。BERT模型首先处理序列文本,形成单个字符,在句子开始和结尾分别添加[CLS]和[SEP]特殊标记进行分隔;其次,每个嵌入序列都包含词向量(token embeddings)、段落嵌入(segment embeddings) 和位置信息(position embeddings)3部分;再次,将词向量输入双向Trm;最后,输出具有语义特征的向量。
|
| 图 4 BERT模型结构 |
BERT模型的主要任务包括掩码语言模型(masked language model, MLM)和下一句预测(next sentence prediction, NSP)。在训练过程中,BERT模型随机遮盖句中15%的词,并通过MLM任务预测被遮盖的词,解决BERT模型中上下文语境缺失问题[27];通过NSP任务预测2个句子是否存在顺序连接关系。MLM和NSP任务分别用于捕捉词语和句子级别的特征,从而获取高质量和多特征词向量,一定程度上解决了NLP领域的词向量嵌入问题。
2) BiLSTM模型。
BiLSTM为改进的循环神经网络(recurrent neural network, RNN)模型[28],可用于捕获长距离依赖关系和上下文序列信息。BiLSTM引入门控机制和存储单元,克服了传统RNN文本序列过长导致的梯度消失或梯度弥散问题[29-30]。BiLSTM由2个独立的长短期记忆(long short-term memory,LSTM)网络组成,LSTM包括遗忘门、输入门和输出门3个门控单元。遗忘门决定丢弃哪些信息;输入门决定记忆单元保留哪些信息;输出门决定输出哪些信息,并进入下一时刻的循环迭代。LSTM单元结构如图 5所示,其中:xt为t时刻的输入向量;ht-1和ht分别为t-1和t时刻的输出结果;σ为Sigmoid激活函数;ft、it和ot分别为t时刻的遗忘门、输入门和输出门;
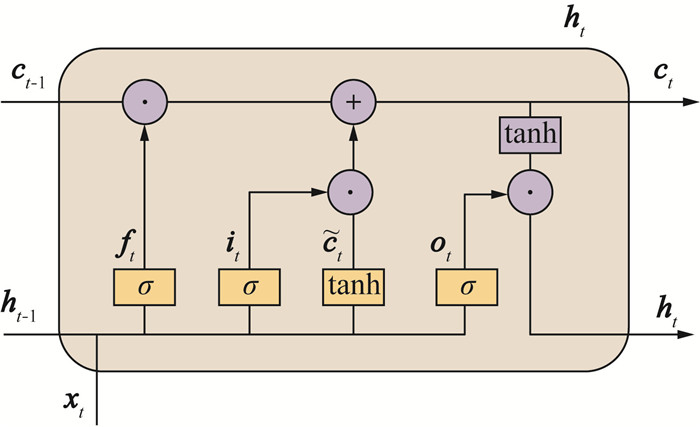
|
| 图 5 LSTM单元结构 |
ft、it、
| $ \boldsymbol{f}_t=\sigma\left(\boldsymbol{W}_f\left[\boldsymbol{h}_{t-1}, \boldsymbol{x}_t\right]+\boldsymbol{b}_f\right), $ | (1) |
| $ \boldsymbol{i}_t=\sigma\left(\boldsymbol{W}_i\left[\boldsymbol{h}_{t-1}, \boldsymbol{x}_t\right]+\boldsymbol{b}_i\right), $ | (2) |
| $ \tilde{\boldsymbol{c}}_t=\tanh \left(\boldsymbol{W}_c\left[\boldsymbol{h}_{t-1}, \boldsymbol{x}_t\right]+\boldsymbol{b}_c\right), $ | (3) |
| $ \boldsymbol{c}_t=\boldsymbol{f}_t \odot \boldsymbol{c}_{t-1}+\boldsymbol{i}_t \odot \tilde{\boldsymbol{c}}_t, $ | (4) |
| $ \boldsymbol{o}_t=\sigma\left(\boldsymbol{W}_o\left[\boldsymbol{h}_{t-1}, \boldsymbol{x}_t\right]+\boldsymbol{b}_o\right), $ | (5) |
| $ \boldsymbol{h}_t=\boldsymbol{o}_t \odot \tanh \left(\boldsymbol{c}_t\right) . $ | (6) |
其中:Wf、Wi、Wo和Wc分别为遗忘门、输入门、输出门和记忆细胞对应的权重矩阵;bf、bi、bo和bc均为偏置向量。
在文本语料中,一个词不仅与前面的词有关,也可能与后面若干个词有关,LSTM只能获取前一时刻的信息,而BiLSTM的输入序列分别以正向和反向输入至2个LSTM神经网络进行特征提取,可兼顾上下文信息。前一时刻与后一时刻的信息同等重要,假设正向和反向LSTM隐藏状态输出序列分别为htf和htb,则[htf, htb] 为BiLSTM在t时刻的输出。
3) CRF模型。
CRF为序列标记模型,该模型通过考虑相邻标签的关系,分析标签序列的联合概率,给出全局最优的标签序列,从而确保最终预测标签的合理性[31]。CRF模型可通过邻近标签关系找到最优的预测序列[32],从而弥补BiLSTM在处理相邻标签依赖关系上的不足。
若n为输入句子中字的数量,X={x1, x2, …, xn}为输入文本序列,Y={y1, y2, …, yn} 为对应的输出标签序列,则X对应Y的得分S(X, Y)表示如下:
| $ S(X, Y)=\sum\limits_{i=1}^n A_{y_{i-1}, y_i}+\sum\limits_{i=1}^n P_{i, y_i} . $ | (7) |
其中:Ayi-1, yi为标签yi-1转移至yi的分数;Pi, yi为第i个字被预测为标签yi的分数。Ayi-1, yi越大,则标签yi-1转移至yi的可能性越大。Y的条件概率为P(Y|X),表示如下:
| $ P(Y \mid X)=\frac{\mathrm{e}^{S(X, Y)}}{\sum\limits_{\widetilde{Y} \in Y_X} \mathrm{e}^{S(X, \widetilde{Y})}}. $ | (8) |
其中:
| $ Y^*=\underset{\widetilde{Y} \in Y_X}{\operatorname{argmax}} S(X, \widetilde{Y}). $ | (9) |
本文将上述3种模型集成BERT-BiLSTM-CRF模型,如图 6所示。BERT层用于向量化表示句子中的字符,每个字符的向量化表示不仅包含该字符信息,还包含该字符在句子中的上下文信息,为后续语义特征的提取和序列标注任务提供高质量的特征输入;BiLSTM层用于处理BERT层输出的向量表示,通过双向结构有效整合正向和反向的语义流,获取向量的上下文语义特征,输出矩阵为Pi;CRF层为模型的输出层,通过考虑整个标签序列的联合概率分布,推断全局最优的标签序列。综上所述,BERT-BiLSTM-CRF通过融合深层语义编码、上下文信息整合和结构化输出决策,为复杂的序列标注任务提供有效的解决方案。
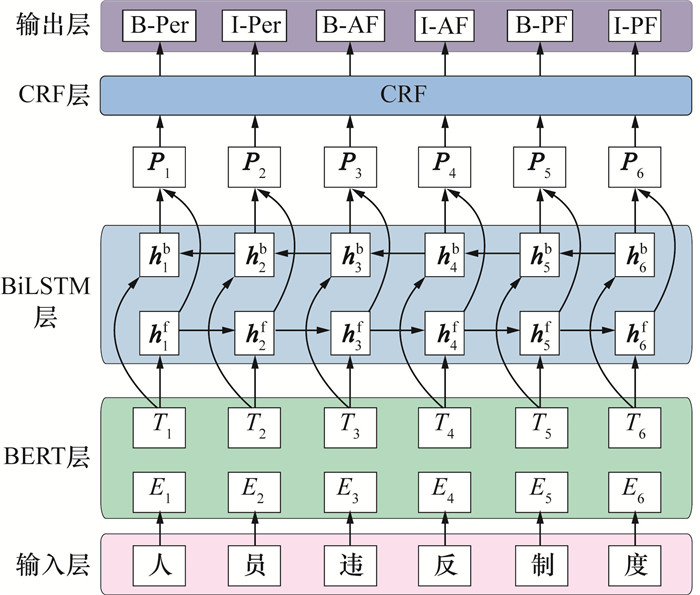
|
| 图 6 BERT-BiLSTM-CRF框架图 |
2.2.2 模型评估
本文采用精确率P、召回率R和综合指标F1对比BERT-BiLSTM-CRF、BiLSTM和BiLSTM-CRF模型,如表 1所示。不同训练轮次下的损失和评估指标如图 7a所示,随着损失曲线逐渐收敛平滑,BERT-BiLSTM-CRF模型的P、R和F1等参数逐渐提升,并最终趋向稳定。
| % | |||||||||||||||||||||||||||||
| 模型 | P | R | F1 | ||||||||||||||||||||||||||
| BERT-BiLSTM-CRF | 95.42 | 94.05 | 94.73 | ||||||||||||||||||||||||||
| BiLSTM | 91.26 | 90.96 | 90.61 | ||||||||||||||||||||||||||
| BiLSTM-CRF | 93.50 | 92.94 | 93.22 | ||||||||||||||||||||||||||
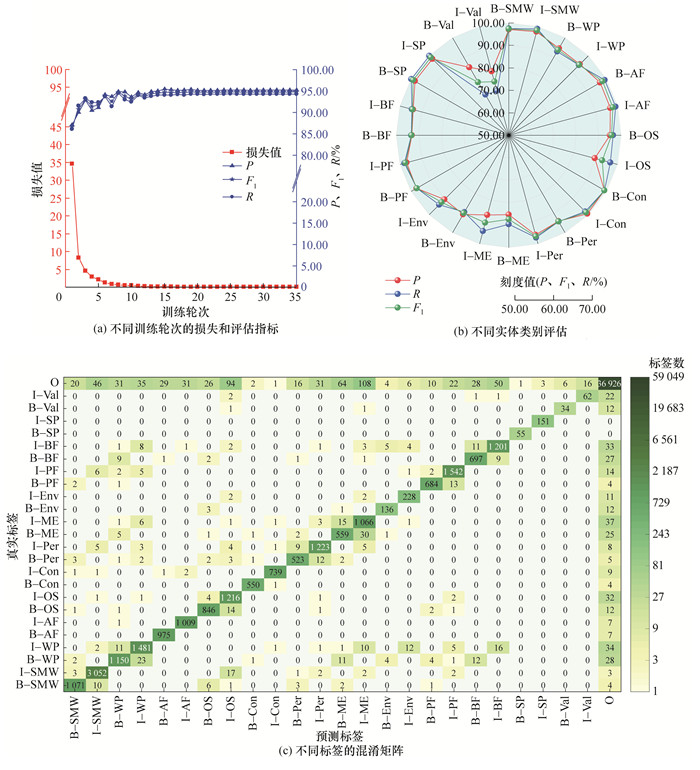
|
| 图 7 BERT-BiLSTM-CRF模型评估 |
本文为进一步明确语料库中实体的分布和预测情况,分别对每个实体类别的识别结果进行评估,如图 7b所示,结果表明仅有少数实体识别结果的P相对较低,如B-Val和I-Val的P分别为85.00%和79.49%。本文采用混淆矩阵描述了算法性能的可视化结果[33],如图 7c所示。B-Val标签中有34个被正确预测,有12个被错误预测为O;I-Val中有62个被预测正确,有22个被错误预测为O。原因是B-Val和I-Val在语料库中出现的次数较少,此类实体的识别P相对较低。
3 事故原因识别事故原因识别方法主要包括NER、SDP和TC。本文采用NER和SDP技术分析了实体类型的语义关系,提取了个体动作和组织原因的文本表示模式,用于识别个体动作原因和组织原因;基于TC算法训练了个体能力原因TC模型,用于识别个体能力原因。本文选取86起典型煤矿事故案例作为数据支撑,并根据24Model的定义详细分析了各类事故原因,事故原因统计结果如图 8所示。本文从86起事故中选取9起作为最终测试数据,其他数据用于分析总结实体语义关系和训练个体能力因素分类模型。
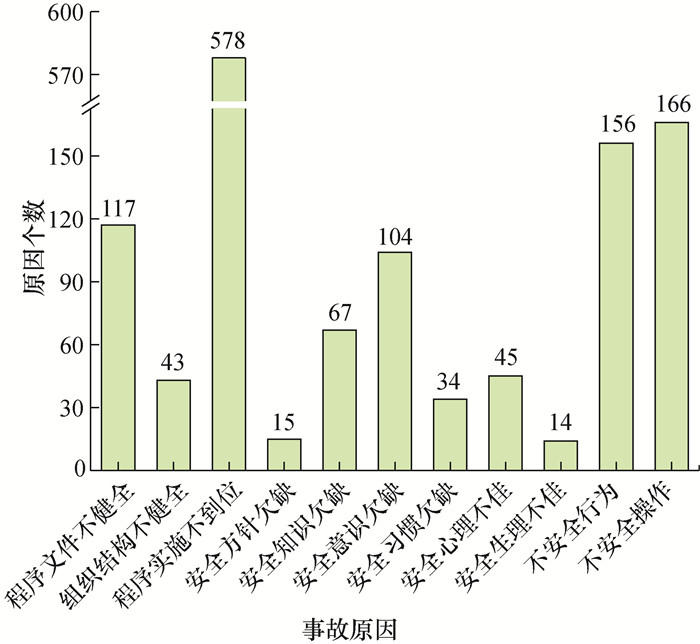
|
| 图 8 86起煤矿事故原因统计结果 |
3.1 SDP
SDP是建立在依存理论基础上的深层语义分析技术,融合了句子中的依存结构和语义信息,能更好地表达句子的结构和语义关系[34]。SDP用于处理词、短语、从句和句子级别语义结构,是对整个句子的深层分析,能够表达句子的深层语义信息,减轻句子成分顺序对语义理解的干扰。本文使用语义依存图表达句子的依存信息,将煤矿事故中全要素信息之间的语义结构可视化。本文在标注事故文本时,遵循北京语言大学应用语言学研究所(NLPInBLCU)提出的语义依存图结构语义关系标注规范[35]。该规范的语义依存图结构比较全面,有利于指导事故文本语料标注工作,为计算机理解煤矿事故文本中的深层语义奠定了基础。
根据SDP理论,主体和客体角色与谓词有直接的语义关系。主体角色以作主语为主要句法实现形式;客体角色以作宾语为主要句法实现形式[36]。主体角色包括施事和当事;客体角色包括受事、客事、成事和系事等。本文主要语义角色及定义如表 2所示。
| 粗粒度语义角色 | 细粒度语义角色 | 定义 |
| 主体角色 | 施事 | 发出具体行为动作的主体或动作持续,以及表现心理活动的有意识主体,具有主观能动性 |
| 当事 | 与施事的最大不同是非行为动作的发出者,不具有主观能动性,包括无意识运动、非可控运动和各种关系的主体 | |
| 客体角色 | 受事 | 被主体行为动作改变的直接客体,具有被动性 |
| 客事 | 事件所涉及但并未改变的客体和动作行为产生的新事物或结果 | |
| 成事 | 主体创建或产生的新事物 | |
| 系事 | 与事件参与者有关系的客体 |
3.2 个体动作和组织原因
根据24Model理论可知,事故原因主要是个体或组织的不安全行为,识别事故原因主要在于识别具体错误行为及其发出者和作用对象。从中文语义结构来看,错误行为或状态的发出者往往为主体角色,错误行为或状态为谓词,错误行为的作用对象为客体。
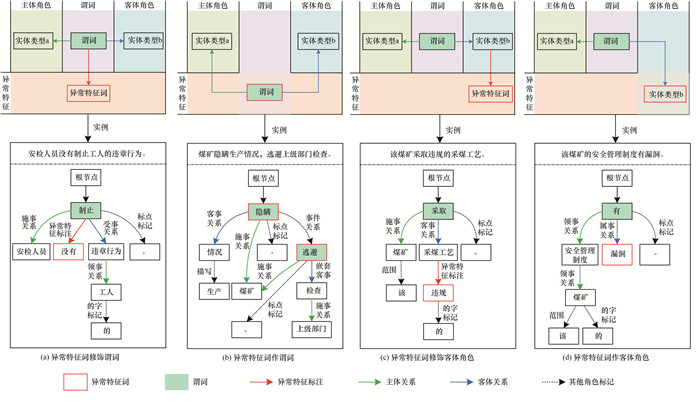
本文提取了异常特征实体与主体角色、谓词和客体角色关联的主要语义结构,如图 9所示。异常特征一般有以下2种形式:1) 作为否定词;2) 有明显贬义性质的动词、名词或形容词。当异常特征为否定词时,常作为否定标记修饰根节点或客体角色。当异常特征为贬义词时,若为动词或形容词,则可直接充当谓语,如图 9b中的隐瞒和逃避;若为名词,则直接充当客体角色。
|
| 图 9 异常特征语义结构关系 |
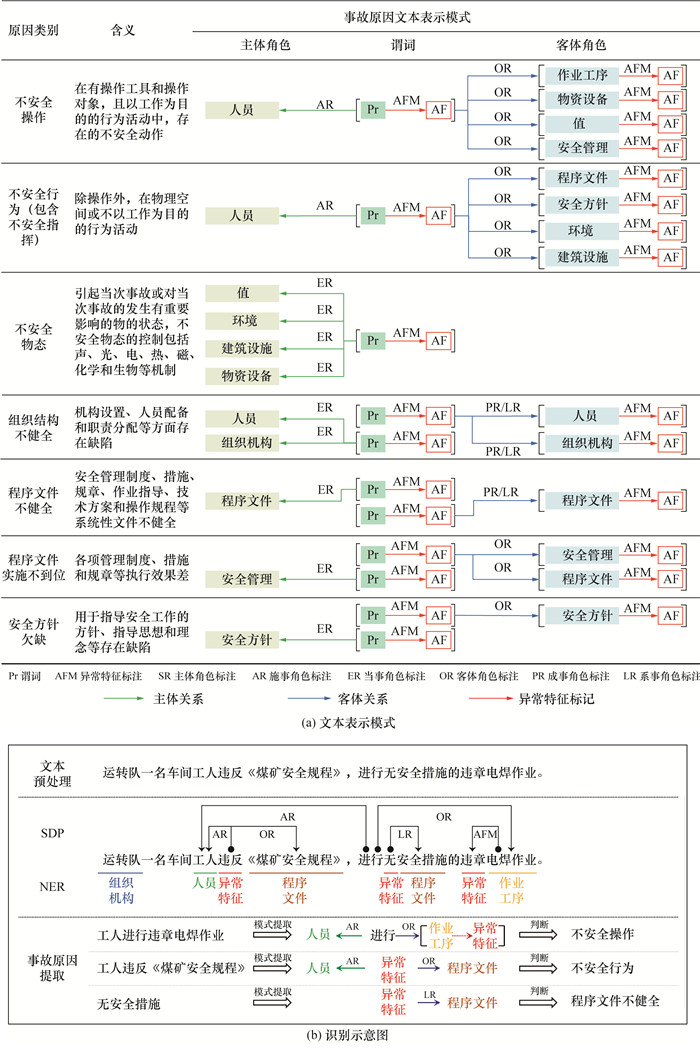
本文结合异常特征的主要语义结构,提取了24Model中不同类别原因文本的表示模式,主要由实体的语义角色和语义关系组成,如图 10a所示。其中谓词列表示异常特征词与谓词相关或异常特征词作谓词的情况;客体角色列表示异常特征词与客体相关或异常特征词作客体角色的情况。
|
| 图 10 个体动作和组织原因文本表示模式及识别示意图 |
个体不安全动作中实施主体分为人和物,以人为实施主体包括不安全操作、不安全行为和不安全指挥;不安全物态以物为主体,主要包括生产工作中涉及的具体物体、作业区域和环境,如生产工具、物资、设备、建筑设施,以及气象和光照等条件,在本文构建的知识概念体系中,这些实体包含在环境、建筑设施和物资设备3个实体类型中。
组织因素包括安全管理体系和安全文化,二者的实施主体均为组织。由于傅贵等[24]强调安全管理体系应重点关注程序文件的建立和执行情况,因此在安全管理体系中添加“程序文件实施不到位”类别。安全文化也称为安全方针、安全思想、安全宗旨、安全信仰、安全价值观和安全理念等[20]。
个体动作和组织原因识别流程如图 10b所示,首先,对文本进行预处理;其次,识别文本中的实体,并利用SDP技术分析文本中实体的语义关系;最后,将这些语义关系与图 10a中的文本表示模式匹配,识别事故原因类别。从文本中提取不安全操作、不安全行为和程序文件不健全等3种事故原因。
3.3 个体能力原因个体能力包括安全知识、安全意识、安全习惯、安全心理、安全生理等类别因素,每个类别都有严格的定义,本文利用TC方法训练了有针对性的分类模型,可有效识别个体能力因素。
频率(term frequency,TF)-逆文档频率(inverse document frequency,IDF)是一种有效的关键词提取方法,考虑了词在文档中的TF和在语料库中的IDF,可有效提取不同类别的典型特征词[37]。
本文根据个体能力各类因素的定义,从事故文本中提取相应的文本语料,基于TF-IDF识别不同类别的典型特征词,并用词云图展示,如表 3所示。
| 个体能力 | 含义 | 词云图 | 特征词(前5) | TF-IDF |
| 安全知识 | 指与动作密切相关的理论知识、经验和技能等内容的统称 | 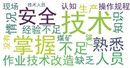 |
技术 | 0.537 542 05 |
| 掌握 | 0.368 833 66 | |||
| 安全 | 0.299 320 90 | |||
| 熟悉 | 0.177 978 25 | |||
| 不足 | 0.149 421 72 | |||
| 安全意识 | 指及时发现和处理危险源的能力 | 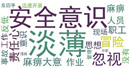 |
淡薄 | 0.575 044 42 |
| 安全意识 | 0.537 571 15 | |||
| 忽视 | 0.226 150 29 | |||
| 冒险 | 0.223 436 20 | |||
| 责任心 | 0.195 628 64 | |||
| 安全习惯 | 指与事故发生密切相关,且经常重复做的动作 | 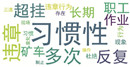 |
习惯性 | 0.749 614 24 |
| 违章 | 0.335 213 07 | |||
| 多次 | 0.314 072 54 | |||
| 超挂 | 0.219 008 63 | |||
| 反复 | 0.216 796 42 | |||
| 安全心理 | 指与事故发生密切相关的心理状态 | 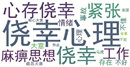 |
侥幸心理 | 0.506 052 21 |
| 侥幸 | 0.372 615 56 | |||
| 心存侥幸 | 0.309 673 74 | |||
| 紧张 | 0.289 532 36 | |||
| 麻痹思想 | 0.156 742 18 | |||
| 安全生理 | 指与事故发生密切相关的生理状态 | 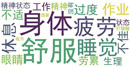 |
(不)舒服 | 0.607 726 23 |
| 身体 | 0.565 607 25 | |||
| 疲劳 | 0.316 885 82 | |||
| 睡觉 | 0.297 351 76 | |||
| 休息 | 0.166 355 07 |
本文利用BERT模型对个体能力因素进行分类,BERT模型在TC方面性能较好[10];利用Jieba分词工具,根据本文建立的煤矿安全管理词库对文本进行预处理,并输入BERT模型进行训练。
本文为评估BERT模型的分类效果,将分类结果与快速文本分类器(FastText)、支持向量机(support vector machine,SVM)、朴素Bayes分类器(naive Bayesian classifier,NBC)、文本卷积神经网络(text convolutional neural network,TextCNN)等模型进行对比,如表 4所示,其中BERT模型效果最佳。
4 评估与应用
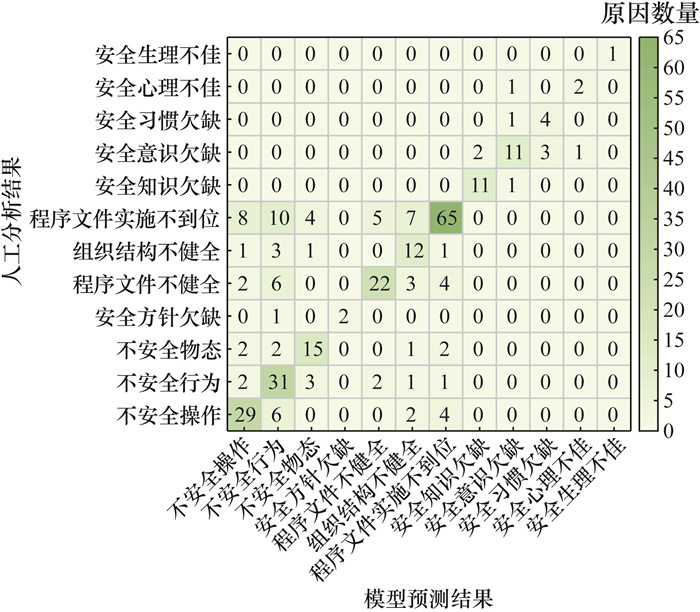
为评估本文所提事故原因识别方法在案例分析中的应用效果和性能,本文对比了人工分析与模型预测结果,并绘制了混淆矩阵,如图 11所示,模型预测结果的P、R和F1值分别为73.09%、73.16% 和72.08%。图 11中副对角线上的数字为被准确预测的原因数量,如不安全操作因素,总数为41,被准确预测的有29个,R约70.73%;有6个被预测为不安全行为、2个被预测为组织结构不健全、4个被预测为程序文件实施不到位。从整体来看,大部分原因均可被准确预测。
|
| 图 11 测试数据混淆矩阵 |
造成本文预测误差的主要原因是事故的文本表达方式和用词用语等复杂多样,不规范的表达容易对NER和SDP造成影响;另外,NER与SDP联合使用,模型间存在一定程度的误差传递。后续可逐步扩大训练语料的规模和数量,缓解这一问题。
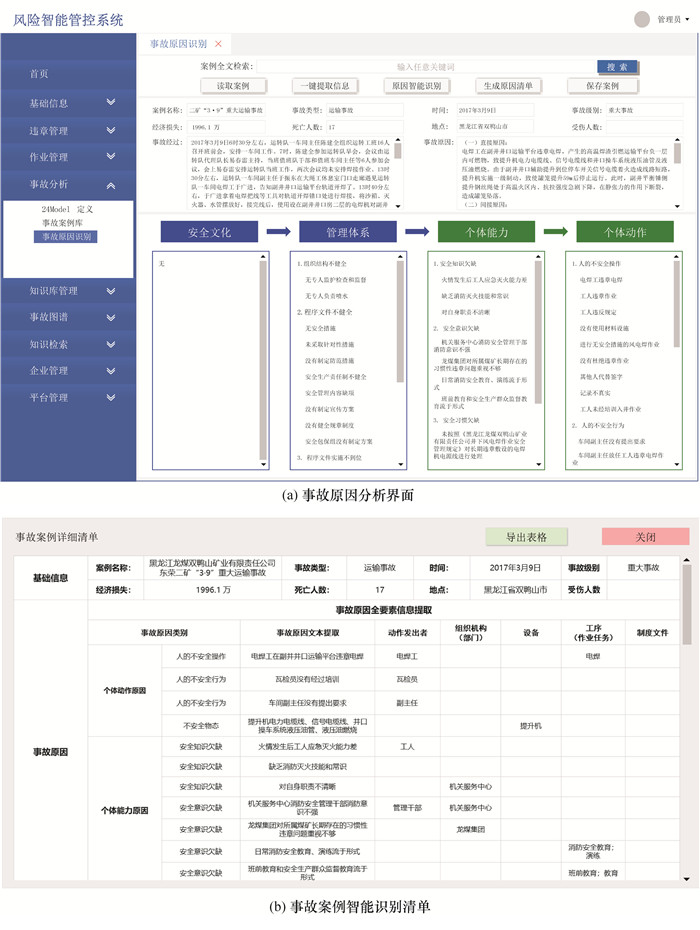
除识别事故原因类型外,NER模型还可识别事故原因中涉及的具体人员、设备物资和建筑环境等信息,便于统计和分析事故。本文将所提理论方法开发为应用程序,嵌入煤矿企业的风险管控流程,辅助相关人员进行事故原因分析和案例学习。黑龙江龙煤双鸭山矿业有限责任公司东荣二矿“3·9”重大运输事故原因智能识别界面如图 12所示。
|
| 图 12 事故原因智能识别界面 |
对于记录规范的事故报告,该应用程序可智能识别事故的基本信息,提升事故录入效率。在进行事故原因分析时,程序中设计了24Model定义模块,结合本文所提事故原因识别方法,将识别结果与24Model框架对应,利用24Model的逻辑性和系统性帮助决策者梳理事故原因。
根据识别结果可生成事故案例信息清单,包含事故案例的基础信息和事故原因体系。事故原因的全要素信息运用NER结果,在个体错误动作中可识别错误动作的发出者和涉及的设备及作业工序,在管理体系中可识别缺失的制度文件等信息,帮助煤矿从业人员快速学习和分析事故案例,从而更有效地预防事故。
本文训练的实体识别模型中融入了大量煤矿安全术语,可减少因从业人员不熟悉相关知识而导致的差错。本文结合24Model提出的事故智能分析方法,不仅能提升事故分析效率,而且有助于推动事故致因理论在煤矿企业的应用,规范和统一相关人员对事故原因的认识和分析思路,帮助煤矿企业提升安全管理能力。
5 结论本文研究了适用于24Model的事故智能分析方法,并提出了事故原因智能识别方法。本文首先根据煤矿行业标准和事故案例,构建了煤矿事故领域概念体系,其中包括12个实体类型;其次,集成BERT-BiLSTM-CRF模型,训练了煤矿事故领域NER模型,该模型的精确率达95.42%;再次,按照24Model的定义,结合NER和SDP技术识别个体动作、管理体系和安全文化等原因,利用TC技术识别安全知识、安全意识、安全习惯、安全心理和安全生理等原因;最后,设计开发了应用程序,将事故智能分析方法应用于现场安全管理。
本文提出了遵循事故致因理论逻辑和定义的事故智能分析方法,提升了因素识别结果的系统性和逻辑性;在事故学习和分析过程中,有助于解决煤矿从业人员因工作经验和应用事故致因理论熟练程度差异导致的理解偏差问题,可规范和统一煤矿从业人员对事故原因的认识,提升安全管理水平;集成BERT-BiLSTM-CRF模型提出了事故智能分析方法,有效提升了事故分析和学习效率。煤矿风险文本信息的挖掘和提取是煤矿安全智能化发展的重要环节,智能化事故致因分析方法不仅可用于事故分析,而且后续可扩展至隐患及其他风险管理过程,推动智能化模型与风险管理深度融合。
| [1] |
JACOBSSON A, EK Å, AKSELSSON R. Method for evaluating learning from incidents using the idea of "level of learning"[J]. Journal of Loss Prevention in the Process Industries, 2011, 24(4): 333-343. DOI:10.1016/j.jlp.2011.01.011 |
| [2] |
MOURA R, BEER M, PATELLI E, et al. Learning from major accidents to improve system design[J]. Safety Science, 2016, 84: 37-45. DOI:10.1016/j.ssci.2015.11.022 |
| [3] |
吕千, 傅贵. 事故调查报告中事故原因分析的改进: 基于企业事故案例学习视角[J]. 中国安全生产科学技术, 2021, 17(10): 172-178. LÜ Q, FU G. Improvement of cause analysis in accident investigation reports: A perspective of enterprise accident cases learning[J]. Journal of Safety Science and Technology, 2021, 17(10): 172-178. (in Chinese) |
| [4] |
LI W J, ZHANG L B, LIANG W. An accident causation analysis and taxonomy (ACAT) model of complex industrial system from both system safety and control theory perspectives[J]. Safety Science, 2017, 92: 94-103. DOI:10.1016/j.ssci.2016.10.001 |
| [5] |
CHEN Q L, WOOD M, ZHAO J S. Case study of the Tianjin accident: Application of barrier and systems analysis to understand challenges to industry loss prevention in emerging economies[J]. Process Safety and Environmental Protection, 2019, 131: 178-188. DOI:10.1016/j.psep.2019.08.028 |
| [6] |
FU G, XIE X C, JIA Q S, et al. The development history of accident causation models in the past 100 years: 24Model, a more modern accident causation model[J]. Process Safety and Environmental Protection, 2020, 134: 47-82. DOI:10.1016/j.psep.2019.11.027 |
| [7] |
LI J, QIN Y R, WANG Z, et al. How to analyse the injury based on 24Model: A case study of coal mine gas explosion injury[J]. Injury Prevention, 2021, 27(6): 542-553. DOI:10.1136/injuryprev-2021-044281 |
| [8] |
YANG L, WANG X, ZHU J Q, et al. Risk factors identification of unsafe acts in deep coal mine workers based on grounded theory and HFACS[J]. Frontiers in Public Health, 2022, 10: 1-15. |
| [9] |
QIAO W G, LI X C, LIU Q L. Systemic approaches to incident analysis in coal mines: Comparison of the STAMP, FRAM and "2-4" models[J]. Resources Policy, 2019, 63: 1-10. |
| [10] |
JIA Q S, FU G, XIE X C, et al. Enhancing accident cause analysis through text classification and accident causation theory: A case study of coal mine gas explosion accidents[J]. Process Safety and Environmental Protection, 2024, 185: 989-1002. DOI:10.1016/j.psep.2024.03.066 |
| [11] |
GONCALVES FILHO A P, JUN G T, WATERSON P. Four studies, two methods, one accident: An examination of the reliability and validity of Accimap and STAMP for accident analysis[J]. Safety Science, 2019, 113: 310-317. DOI:10.1016/j.ssci.2018.12.002 |
| [12] |
OLSEN N S, SHORROCK S T. Evaluation of the HFACS-ADF safety classification system: Inter-coder consensus and intra-coder consistency[J]. Accident Analysis & Prevention, 2010, 42(2): 437-444. |
| [13] |
LYU Q, FU G, WANG Y X, et al. How accident causation theory can facilitate smart safety management: An application of the 24Model[J]. Process Safety and Environmental Protection, 2022, 162: 878-890. DOI:10.1016/j.psep.2022.04.068 |
| [14] |
CHENG P X, XIAO W X, NING P S, et al. ARTCDP: An automated data platform for monitoring emerging patterns concerning road traffic crashes in China[J]. Accident Analysis & Prevention, 2022, 174: 1-10. |
| [15] |
FENG X Y, DAI Y Y, JI X, et al. Application of natural language processing in HAZOP reports[J]. Process Safety and Environmental Protection, 2021, 155: 41-48. DOI:10.1016/j.psep.2021.09.001 |
| [16] |
GUO S Y, DING L Y, LUO H B, et al. A big-data-based platform of workers' behavior: Observations from the field[J]. Accident Analysis & Prevention, 2016, 93: 299-309. |
| [17] |
SINGLE J I, SCHMIDT J, DENECKE J. Knowledge acquisition from chemical accident databases using an ontology-based method and natural language processing[J]. Safety Science, 2020, 129: 1-13. |
| [18] |
YAN K, WANG Y H, JIA L M, et al. A content-aware corpus-based model for analysis of marine accidents[J]. Accident Analysis & Prevention, 2023, 184: 2-19. |
| [19] |
MORAIS C, YUNG K L, JOHNSON K, et al. Identification of human errors and influencing factors: A machine learning approach[J]. Safety Science, 2022, 146: 1-15. |
| [20] |
傅贵, 陈奕燃, 许素睿, 等. 事故致因"2-4"模型的内涵解析及第6版的研究[J]. 中国安全科学学报, 2022, 32(1): 12-19. FU G, CHEN Y R, XU S R, et al. Detailed explanations of 24Model and development of its 6th version[J]. China Safety Science Journal, 2022, 32(1): 12-19. (in Chinese) |
| [21] |
HEINRICH H W. Industrial accident prevention: A scientific approach[M]. 2nd ed. New York and London: McGraw-Hill Book Company, 1941.
|
| [22] |
REASON J. Human error[M]. Cambridge: Cambridge University Press, 1990.
|
| [23] |
STEWART J M. Managing for world class safety[M]. New York: John Wiley & Sons, 2002.
|
| [24] |
傅贵, 王秀明, 李亚. 事故致因"2-4"模型及其事故原因因素编码研究[J]. 安全与环境学报, 2017, 17(3): 1003-1008. FU G, WANG X M, LI Y. On the 24Model and the application of its causative codes to the analysis of the related accidents[J]. Journal of Safety and Environment, 2017, 17(3): 1003-1008. (in Chinese) |
| [25] |
CAI B Q, TIAN S W, YU L, et al. ATBBC: Named entity recognition in emergency domains based on joint BERT-BILSTM-CRF adversarial training[J]. Journal of Intelligent & Fuzzy Systems, 2024, 46(2): 4063-4076. DOI:10.1007/s42979-024-02835-z |
| [26] |
RUANO-ORDÁS D, MÉNDEZ J R, BASTO FERNANDES V, et al. Novel tools for the management, representation, and exploitation of textual information[J]. Scientific Programming, 2021, 2021: 1-3. |
| [27] |
WU X, LÜ S W, ZANG L J, et al. Conditional BERT contextual augmentation[C]//Proceedings of the 19th International Conference on Computational Science. Faro, Portugal: Springer, 2019: 84-95.
|
| [28] |
王昀, 胡珉, 塔娜, 等. 大语言模型及其在政务领域的应用[J]. 清华大学学报(自然科学版), 2024, 64(4): 649-658. WANG Y, HU M, TA N, et al. Large language models and their application in government affairs[J]. Journal of Tsinghua University (Science and Technology), 2024, 64(4): 649-658. DOI:10.16511/j.cnki.qhdxxb.2023.26.042 (in Chinese) |
| [29] |
DU J L, MI W, DU X L. Chinese word segmentation in electronic medical record text via graph neural network-bidirectional LSTM-CRF model[C]//Proceedings of 2020 IEEE International Conference on Bioinformatics and Biomedicine. Seoul, South of Korea: IEEE, 2020: 985-989.
|
| [30] |
GAO W C, ZHENG X H, ZHAO S S. Named entity recognition method of Chinese EMR based on BERT-BiLSTM-CRF[J]. Journal of Physics: Conference Series, 2021, 1848(1): 1-9. |
| [31] |
DUAN J Y, WANG B, TAN Z, et al. Chinese spelling check via bidirectional LSTM-CRF[C]//Proceedings of the 2019 IEEE 8th Joint International Information Technology and Artificial Intelligence Conference. Chongqing, China: IEEE, 2019: 1333-1336.
|
| [32] |
王立平, 张超, 蔡恩磊, 等. 面向自主工业软件的知识提取和知识库构建方法[J]. 清华大学学报(自然科学版), 2022, 62(5): 978-986. WANG L P, ZHANG C, CAI E L, et al. Knowledge extraction and knowledge base construction method from industrial software packages[J]. Journal of Tsinghua University (Science and Technology), 2022, 62(5): 978-986. DOI:10.16511/j.cnki.qhdxxb.2022.22.023 (in Chinese) |
| [33] |
RUUSKA S, HÄMÄLÄINEN W, KAJAVA S, et al. Evaluation of the confusion matrix method in the validation of an automated system for measuring feeding behaviour of cattle[J]. Behavioural Processes, 2018, 148: 56-62. DOI:10.1016/j.beproc.2018.01.004 |
| [34] |
ZHANG M S. A survey of syntactic-semantic parsing based on constituent and dependency structures[J]. Science China Technological Sciences, 2020, 63(10): 1898-1920. DOI:10.1007/s11431-020-1666-4 |
| [35] |
NLPInBLCU. Chinese semantic dependency document[R/OL]. (2020-12-16)[2024-6-11]. https://github.com/NLPInBLCU/ChineseSemanticDependencyDocument.
|
| [36] |
袁毓林. 论元角色的层级关系和语义特征[J]. 世界汉语教学, 2002(3): 10-22. YUAN Y L. On the hierarchical relation and semantic features of the thematic roles[J]. Chinese Teaching in the World, 2002(3): 10-22. (in Chinese) |
| [37] |
YAHAV I, SHEHORY O, SCHWARTZ D. Comments mining with TF-IDF: The inherent bias and its removal[J]. IEEE Transactions on Knowledge and Data Engineering, 2019, 31(3): 437-450. DOI:10.1109/TKDE.2018.2840127 |
| [38] |
YAO T J, ZHAI Z G, GAO B T. Text classification model based on fastText[C]//Proceedings of 2020 IEEE International Conference on Artificial Intelligence and Information Systems. Dalian, China: IEEE, 2020: 154-157.
|
| [39] |
WANG F, DENG X, HOU L Q. Chinese news text multi classification based on naive Bayes algorithm[C]//Proceedings of the 2nd International Symposium on Computer Science and Intelligent Control. Stockholm, Sweden: ACM, 2018: 1-5.
|
| [40] |
WU S Y, SU E T, LEI B Y, et al. TextCNN-based text classification for e-government[C]//Proceedings of the 20196th International Conference on Information Science and Control Engineering. Shanghai, China: IEEE, 2019: 929-934.
|